De la sigmoïde au premier neurone#
Dans la leçon précédente, notre modèle d’arrosage a appris à calculer un score à partir de la température et de l’humidité.
Nous avions :
température
      +
humidité
      ↓
   paramètres
      ↓
     score
      ↓
   décision
Mais quelque chose nous gênait.
Notre modèle pouvait produire :
-4.93
0.01
3.05
Puis nous lui demandions simplement :
si score > 0 → arroser
sinon         → ne pas arroser
Cela fonctionne pour prendre une décision.
Mais nous perdons immédiatement une information.
Un score de 0.01 et un score de 8 donnent tous les deux la même réponse :
arroser
Pourtant, ces deux scores ne racontent manifestement pas la même chose.
Nous avions donc terminé la leçon précédente avec une question :
Comment transformer notre score en une sortie comprise entre 0 et 1 ?
Essayons.
Une fonction entre 0 et 1#
Nous cherchons une fonction capable de recevoir n’importe quel score et de le ramener entre 0 et 1.
Une fonction est particulièrement adaptée à ce travail : la sigmoïde.
Sa formule est :
sigmoid(x) = 1 / (1 + exp(-x))
Elle peut sembler un peu moins accueillante que notre score habituel.
Plutôt que de commencer par la décortiquer, regardons ce qu’elle fait.
Pendant notre précédente expérience, nous avons calculé quelques valeurs :
| Score | Sigmoïde |
|---|---|
| -4 | 0.018 |
| -2 | 0.119 |
| -1 | 0.269 |
| 0 | 0.500 |
| 1 | 0.731 |
| 2 | 0.881 |
| 4 | 0.982 |
Une première chose apparaît.
Les scores négatifs donnent des valeurs inférieures à 0.5.
Les scores positifs donnent des valeurs supérieures à 0.5.
Et exactement au milieu :
sigmoid(0) = 0.5
Essayons d’aller plus loin.
Pour un score de 8, nous avons obtenu :
sigmoid(8) = 0.9996646498695336
Nous sommes donc très près de 1.
Très près.
Mais toujours pas 1.
Notre sigmoïde semble décidément peu disposée à prendre des décisions définitives.
Et dans l’autre direction, elle se comporte de la même manière : elle se rapproche de 0 sans l’atteindre.
Une drôle de courbe en S#
Les nombres nous donnent déjà une indication.
Le graphique rend le comportement beaucoup plus visible.
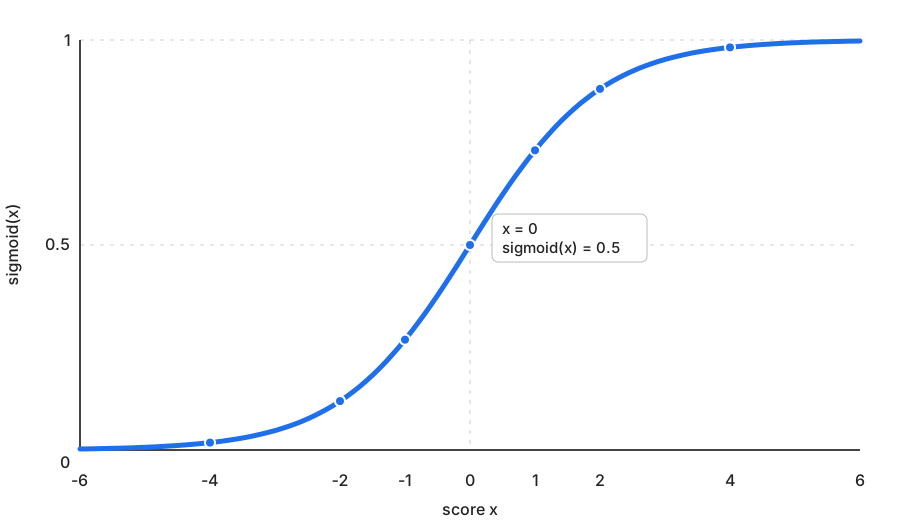
y = 1 / (1 + exp(-x))
Nous retrouvons nos valeurs sur cette courbe.
À gauche, elle se rapproche progressivement de 0.
Au centre :
x = 0
y = 0.5
À droite, elle se rapproche progressivement de 1.
Et surtout, la courbe est beaucoup plus sensible autour de son centre.
C’est exactement la propriété qui nous intéressait.
Notre score n’est plus brutalement transformé en 0 ou en 1.
Nous conservons une valeur intermédiaire.
Revenons à notre arrosage#
Nous connaissons déjà les paramètres appris précédemment :
poids température = 0.38
poids humidité    = -0.19
biais              = 0.01
Essayons avec :
température = 28 °C
humidité    = 40 %
Notre calcul habituel donne :
score = 28 × 0.38
      + 40 × (-0.19)
      + 0.01

score = 3.05
Faisons maintenant passer 3.05 dans la sigmoïde.
Nous obtenons :
0.9547825265167125
Environ 0.955.
Nous sommes nettement du côté de 1.
Essayons maintenant de conserver 28 °C, mais de faire monter l’humidité à 80 %.
Cette fois :
sortie ≈ 0.010
Nous sommes presque à l’autre extrémité.
Cela correspond assez bien à notre problème d’arrosage :
sortie proche de 0 → ne pas arroser
sortie proche de 1 → arroser
Mais que se passe-t-il entre les deux ?
Cherchons la frontière#
Gardons toujours une température de 28 °C.
Puis faisons varier l’humidité.
Autour de 56 %, nous avions obtenu :
28 °C / 55 % → 0.5498
28 °C / 56 % → 0.5025
28 °C / 57 % → 0.4551
Voilà une situation beaucoup plus intéressante.
À 55 %, notre sortie est légèrement au-dessus de 0.5.
À 57 %, elle est légèrement en dessous.
Et à 56 % :
0.5025
Notre modèle est pratiquement assis sur la clôture.
Il faut pourtant bien décider de quel côté tomber.
Nous pouvons choisir une règle :
sortie >= 0.5 → arroser
sortie <  0.5 → ne pas arroser
Mais cette règle de décision vient après la sigmoïde.
La sigmoïde, elle, conserve la nuance.
Elle nous permet de distinguer une sortie de 0.5025 d’une sortie de 0.9548.
Nous avons donc résolu notre premier problème.
Notre score est devenu une sortie continue entre 0 et 1.
Mais regardons maintenant le programme que nous sommes en train de construire.
Qu’avons-nous fabriqué ?#
Nous avions déjà ceci :
température ──× poids ──┐
                        │
humidité ─────× poids ──┼──> score
                        │
biais ──────────────────┘
Nous venons d’ajouter :
score ──> sigmoïde ──> sortie
Mettons les deux ensemble :
température ──× poids_temperature ──┐
                                   │
humidité ─────× poids_humidite ─────┼──> score ──> sigmoïde ──> sortie
                                   │
biais ──────────────────────────────┘
Regardons ce que nous avons.
Nous avons des entrées.
Chaque entrée possède un poids.
Nous ajoutons un biais.
Nous calculons un score.
Puis nous faisons passer ce score dans une fonction d’activation.
Cela commence à ressembler étrangement à quelque chose.
Nous venons de construire notre premier neurone artificiel.
Et nous l’avons fait presque sans nous en rendre compte.
Notre neurone en Python#
Le programme correspondant est finalement très court :
import math


temperature_weight = 0.38
humidity_weight = -0.19
bias = 0.01


def sigmoid(x):
    return 1 / (1 + math.exp(-x))


def neuron(temperature, humidity):
    score = (
        temperature * temperature_weight
        + humidity * humidity_weight
        + bias
    )

    return sigmoid(score)
Notre fonction neuron() reçoit deux entrées et retourne une sortie.
Nous pouvons ensuite appliquer notre règle de décision :
output = neuron(28, 40)

if output >= 0.5:
    print("arroser")
else:
    print("ne pas arroser")
Nous savons donc maintenant ce qu’est notre premier neurone.
Mais il reste un petit problème.
Et il est de taille.
Nous avons écrit :
temperature_weight = 0.38
humidity_weight = -0.19
bias = 0.01
D’où viennent ces valeurs ?
Qui règle les poids ?#
Nous connaissons déjà la réponse en partie.
Notre neurone dispose de cinq exemples :
| Température | Humidité | Cible |
|---|---|---|
| 22 | 70 | 0 |
| 24 | 65 | 0 |
| 27 | 42 | 1 |
| 29 | 35 | 1 |
| 25 | 55 | 0 |
Pour chacun d’eux, il produit une sortie.
Nous connaissons également la cible.
Il nous faut donc mesurer à quel point les deux sont éloignées.
Cela devrait nous rappeler quelque chose.
Dans la Leçon 03, nous avions utilisé une fonction de perte.
Reprenons le même principe :
erreur = cible - sortie
perte = erreur²
Nous n’avons donc pas besoin d’inventer un nouveau mécanisme.
Nous avons notre neurone.
Nous avons une cible.
Et nous savons maintenant mesurer son erreur.
Une question familière revient alors :
Dans quel sens faut-il modifier les paramètres pour faire diminuer cette perte ?
Un vieil outil revient#
Prenons simplement le poids de la température.
Il vaut :
0.38
Pendant notre expérience, nous l’avons déplacé très légèrement autour de cette valeur :
0.379 → perte ≈ 0.0866
0.380 → perte ≈ 0.0890
0.381 → perte ≈ 0.0916
Lorsque nous augmentons légèrement le poids, la perte augmente.
Nous savons donc quelque chose sur la pente à cet endroit.
Et cette pente porte un nom que nous connaissons déjà :
le gradient.
Nous retrouvons exactement l’idée de la descente de gradient.
Cette fois, elle va nous servir à régler les paramètres de notre neurone.
Nous faisons le même raisonnement pour le poids de l’humidité et pour le biais.
Puis nous pouvons les corriger.
Essayons.
Un premier pas… un peu trop enthousiaste#
Commençons avec :
learning_rate = 0.01
Notre perte avant la correction vaut environ :
0.089041
Après avoir corrigé les trois paramètres :
0.505459
Nous voulions descendre.
Nous sommes montés.
Et pas qu’un peu.
La direction locale nous donnait une information utile, mais notre pas était manifestement trop grand.
Essayons dix fois plus petit :
learning_rate = 0.001
Cette fois :
0.089041 → 0.060073
Voilà qui ressemble davantage à une descente.
Nous avons donc retrouvé un autre élément déjà rencontré dans les leçons précédentes : connaître la direction ne suffit pas.
Il faut aussi avancer avec un pas adapté.
Continuons#
Maintenant que notre premier pas va dans le bon sens, recommençons.
Après dix petits pas, nous avons observé :
départ        0.089041
itération 1   0.060073
itération 2   0.052935
itération 3   0.050631
...
itération 10  0.048669
La perte ne disparaît pas miraculeusement.
Mais elle descend.
Les paramètres ont eux aussi légèrement changé :
poids température ≈  0.3769
poids humidité    ≈ -0.2035
biais              ≈  0.0098
Très bien.
Mais après tous ces calculs, une question est beaucoup plus intéressante que la sixième décimale de notre perte :
Que sait faire notre neurone maintenant ?
Regardons plutôt ses sorties#
Après ces dix itérations :
| Température | Humidité | Cible | Sortie |
|---|---|---|---|
| 22 | 70 | 0 | 0.003 |
| 24 | 65 | 0 | 0.015 |
| 27 | 42 | 1 | 0.838 |
| 29 | 35 | 1 | 0.979 |
| 25 | 55 | 0 | 0.147 |
Les cinq observations se trouvent maintenant du côté attendu de 0.5.
Les trois premières valeurs numériques que nous avions placées dans notre programme n’étaient donc pas figées.
Le neurone peut les corriger à partir des exemples.
Ce sont bien :
les poids
le biais
qui sont appris.
La perte, elle, n’est pas apprise.
Elle nous sert à mesurer comment se comporte le modèle et à guider les corrections.
Une dernière prudence est nécessaire.
Une sortie de :
0.838
est bien comprise entre 0 et 1.
Mais nous n’avons pas démontré qu’elle signifie :
83.8 % de probabilité d'arroser
Pour l’instant, elle nous indique surtout de quel côté de notre frontière se situe l’observation, et à quelle distance de 0.5.
Ce que nous venons de construire#
Nous étions partis avec un problème très simple :
notre modèle produit un score
Nous voulions conserver davantage d’information avant de prendre notre décision.
Nous avons découvert la sigmoïde.
Puis, presque sans le chercher, nous nous sommes retrouvés avec :
entrées
   ↓
poids + biais
   ↓
score
   ↓
sigmoïde
   ↓
sortie
C’était notre premier neurone.
Il restait alors une question :
qui règle ses poids ?
Et pour y répondre, nous n’avons pas eu besoin de repartir de zéro.
Nous avons retrouvé les outils construits dans les leçons précédentes :
sortie
   ↓
cible
   ↓
perte
   ↓
gradient
   ↓
correction des poids et du biais
   ↓
nouvelle sortie
Nous n’avons donc pas changé de monde.
Nous avons simplement assemblé, une à une, des pièces que nous connaissions déjà.
Et cette fois, leur assemblage porte un nom :
un neurone artificiel qui apprend.
Nous n’en avons encore qu’un.
Alors une nouvelle question se pose assez naturellement :
Que pourrait-il se passer si plusieurs neurones travaillaient ensemble ?